El 20 de octubre de 2025 un fallo en la región de Amazon Web Services en Virginia del Norte dejó sin servicio durante horas a aplicaciones, bancos y tiendas de todo el mundo. Qué pasó y qué enseña.
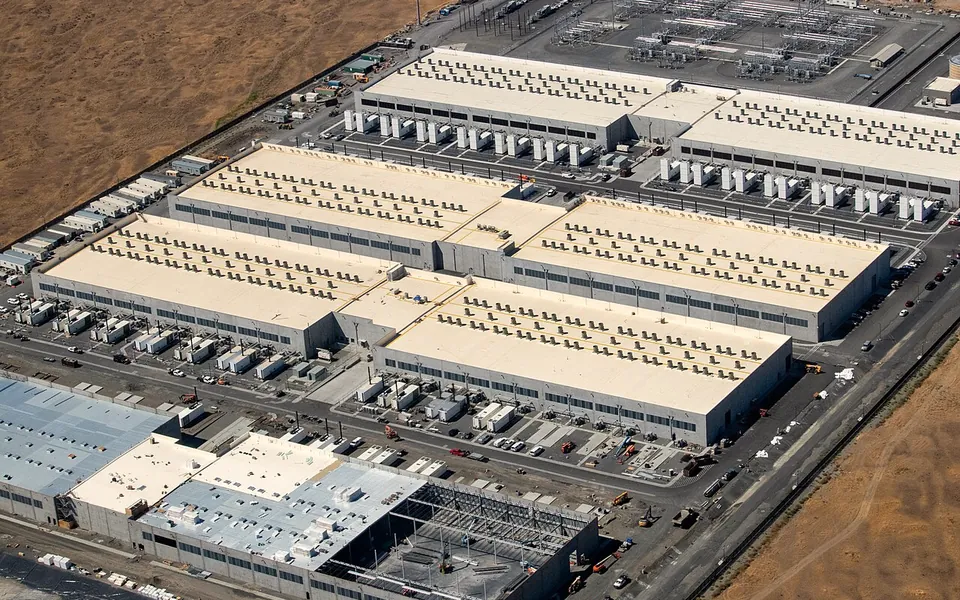
En la madrugada del 20 de octubre de 2025, hora de la costa este de Estados Unidos, la región us-east-1 de Amazon Web Services (AWS), situada en Virginia del Norte, empezó a registrar errores en cadena. Durante buena parte del día, miles de servicios que funcionan sobre la nube de Amazon quedaron caídos o funcionaron a medias en todo el mundo, también en Europa, donde el fallo coincidió con la mañana laborable.
Qué pasó
Según explicó la propia Amazon, el origen fue un problema de resolución de nombres (DNS) que impidió a las aplicaciones encontrar uno de sus servicios de bases de datos, DynamoDB, en esa región. Como muchos otros servicios de AWS dependen de él, el error se propagó. Amazon resolvió el problema de fondo en pocas horas, pero la recuperación completa, con el atasco de tareas pendientes, se prolongó hasta la noche.
Se vieron afectados servicios de mensajería, redes sociales, videojuegos, plataformas de pago, aerolíneas, algunos bancos británicos y los propios servicios de Amazon, como su tienda o sus altavoces inteligentes. Muchas empresas que no sabían que dependían de esa región lo descubrieron ese día, a través de algún proveedor.
Por qué importa
Tres empresas, Amazon, Microsoft y Google, concentran la mayor parte del mercado mundial de la nube. La concentración tiene ventajas, como la escala, la seguridad y el coste, pero también crea puntos únicos de fallo: cuando uno de ellos cae, arrastra a miles de clientes a la vez. Un año antes, en julio de 2024, una actualización defectuosa de CrowdStrike había bloqueado millones de ordenadores con Windows.
En Europa, el reglamento DORA, que se aplica a las entidades financieras desde enero de 2025, obliga precisamente a gestionar el riesgo de los proveedores tecnológicos críticos, y la directiva NIS2 extiende obligaciones parecidas a otros sectores.
Qué conviene revisar
Conviene saber de qué proveedores de nube depende la empresa, directa o indirectamente, y en qué regiones; qué pasa si uno cae durante horas, y si los servicios críticos pueden funcionar desde otra región o con un plan alternativo. También conviene revisar qué dicen los contratos sobre la disponibilidad garantizada y las compensaciones, que suelen ser modestas.
Un plan de continuidad que nunca se ha probado es solo un documento. Consulte con su responsable de tecnología si el suyo contempla la caída de un gran proveedor.
La nube no está en ninguna parte, pero cuando falla se nota en todas.
Este artículo es información general. No es asesoramiento jurídico, fiscal ni de inversión, y no tiene en cuenta las circunstancias particulares de nadie.